

Abstract / Overview
Embedding-based search represents a significant evolution beyond traditional keyword search. Instead of matching literal strings, embeddings encode the semantic meaning of text into high-dimensional vectors, allowing retrieval systems to identify relevant results based on meaning rather than exact words. This approach powers modern search engines, recommendation systems, and AI chat interfaces.
This guide explores advanced embedding-based search workflows using Python. It covers model selection, embedding generation, vector indexing, approximate nearest neighbor (ANN) search, hybrid retrieval, and optimization strategies for scale.
Conceptual Background
From Keywords to Meaning
Conventional search engines use keyword matching and term frequency–inverse document frequency (TF-IDF) to find results. These methods fail when query terms differ from document wording.
Embeddings solve this by mapping text into a vector space where similar meanings are close together. Two sentences with different words but similar intent will yield vectors with high cosine similarity.
Embedding Models
Common Python-accessible embedding models include:
OpenAI text-embedding-3-large — high-precision, general-purpose embeddings.
Sentence-BERT — optimized for sentence similarity tasks.
Instructor XL — embeddings with task-specific fine-tuning capabilities.
Cohere Embeddings API — known for multilingual and cross-domain capabilities.
Step-by-Step Walkthrough
Step 1. Install Required Libraries
pip install openai faiss-cpu sentence-transformers numpyThese libraries handle embedding generation, vector storage, and similarity search.
Step 2. Generate Embeddings
You can use OpenAI embeddings or SentenceTransformers for local inference.
Example: OpenAI Embeddings
from openai import OpenAI
import numpy as np

client = OpenAI(api_key="YOUR_API_KEY")

texts = ["machine learning is fascinating", "deep learning models are complex"]
response = client.embeddings.create(model="text-embedding-3-large", input=texts)

embeddings = [np.array(item.embedding) for item in response.data]
Example: SentenceTransformers (Local)
from sentence_transformers import SentenceTransformer

model = SentenceTransformer('all-MiniLM-L6-v2')
embeddings = model.encode(texts)
Each text converts into a vector of 384–1536 dimensions, depending on the model.
Step 3. Index Embeddings with FAISS
FAISS (Facebook AI Similarity Search) provides efficient vector indexing for similarity search.
import faiss

dimension = embeddings[0].shape[0]
index = faiss.IndexFlatL2(dimension)
index.add(np.array(embeddings))
To search for a query:
query = model.encode(["neural network architectures"])
D, I = index.search(np.array(query), k=2)D: distance scores (lower means closer)I: indices of matched documents
For large datasets, use IndexIVFFlat or HNSW for approximate search.
Step 4. Create Semantic Search Functions
def semantic_search(query, documents, model, index, top_k=5):
    query_emb = model.encode([query])
    D, I = index.search(np.array(query_emb), top_k)
    results = [documents[i] for i in I[0]]
    return results
Example usage:
docs = [
    "AI models learn from data.",
    "Neural networks are a type of AI model.",
    "Classical algorithms rely on rules."
]

results = semantic_search("machine learning", docs, model, index)
print(results)
Step 5. Vector Database Integration
For production systems, store embeddings in a vector database:
| Vector DB | Key Features |
|---|---|
| Pinecone | Managed vector index with metadata filtering |
| Weaviate | Graph-augmented semantic search |
| Milvus | Open-source, scale-ready ANN engine |
| Qdrant | Rust-based, high-performance, filterable vectors |
Example: Pinecone Integration
import pinecone
pinecone.init(api_key="YOUR_API_KEY", environment="us-west1-gcp")

index = pinecone.Index("semantic-search")
vectors = [(str(i), embeddings[i].tolist(), {"text": texts[i]}) for i in range(len(texts))]
index.upsert(vectors)
Search:
query_vector = model.encode(["AI and machine learning"]).tolist()
results = index.query(vector=query_vector, top_k=5, include_metadata=True)
Use Cases / Scenarios
Semantic Document Retrieval: Law, healthcare, and academic search systems benefit from contextual understanding.
Customer Support Bots: Retrieve knowledge base answers semantically.
Recommendation Systems: Match users with similar interest profiles.
Code Search: Find semantically related functions across repositories.
Multilingual Search: Embed text in multiple languages into a shared space.
Hybrid Retrieval Systems
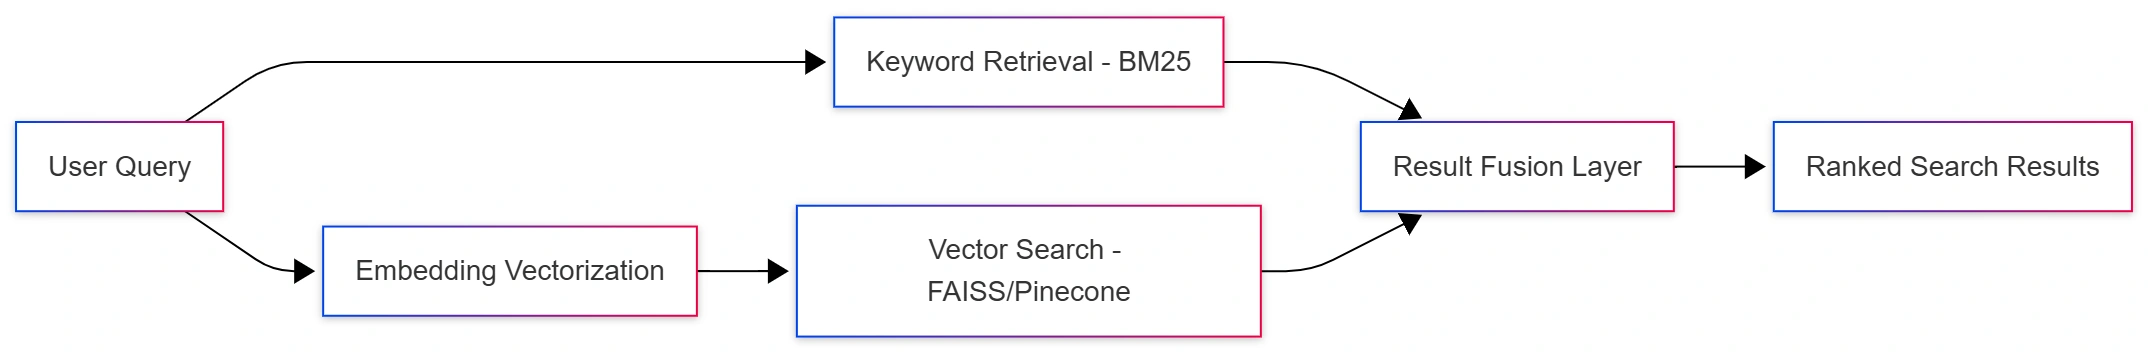
Advanced systems combine keyword and embedding search:
Use BM25 or ElasticSearch for lexical matching.
Use FAISS or vector DBs for semantic recall.
Merge results with weighted scoring.
This hybrid approach improves precision and recall, especially in large enterprise search systems.
Hybrid Architecture Diagram (Mermaid)
Limitations / Considerations
Model bias: Embeddings inherit biases from training data.
Vector drift: Embeddings may become stale as language evolves.
High storage cost: Each vector consumes significant memory.
Latency: Large-scale search requires ANN optimizations or GPU acceleration.
Explainability: Hard to interpret why two texts are considered similar.
Fixes and Optimization Tips
Dimensionality reduction: Use PCA or autoencoders to compress vectors.
Normalization: Apply L2 normalization for consistent similarity metrics.
Caching: Cache frequent queries to minimize recomputation.
Batch processing: Group embedding requests to improve throughput.
Metadata filtering: Combine vector search with structured filters for precision.
FAQs
Q1. Can embeddings work with non-text data?
Yes. Embeddings can represent images, audio, and graphs. Cross-modal models allow matching across data types.
Q2. What similarity metric should I use?
Cosine similarity is standard. Euclidean distance works when embeddings are normalized.
Q3. How do I fine-tune embeddings for domain data?
Use sentence-transformers with contrastive fine-tuning on in-domain sentence pairs.
Q4. What’s the best vector database for large-scale systems?
Milvus or Qdrant are optimal for on-premise scalability; Pinecone for managed setups.
Q5. How do I evaluate embedding quality?
Use benchmarks like MTEB (Massive Text Embedding Benchmark) or domain-specific retrieval tests.
Conclusion
Embedding-based search transforms traditional retrieval systems into meaning-aware engines. With tools like OpenAI Embeddings, FAISS, and vector databases, Python developers can build scalable, intelligent search experiences. The best systems integrate embeddings with keyword and metadata filters to achieve high precision and contextual understanding.
Future directions include cross-modal retrieval, personalized embedding spaces, and continuous vector adaptation with reinforcement feedback.
Join the conversation! Your thoughts help the community grow.